GraphRAG企業知識管理方案:如何用AI內部搜尋提升工作效率 | IoTree
傳統關鍵字搜尋與 Naive RAG(檢索增強生成)因缺乏全域關聯,面臨斷章取義與高達 25% 的 AI 幻覺率;GraphRAG 透過知識圖譜(Knowledge Graph)賦予大語言模型跨文件推理能力。 根據 McKinsey 權威調查,知識型員工平均每週耗費 19%(約 7.
📌 核心重點摘要(Key Takeaways)
- 檢索技術典範轉移:傳統關鍵字搜尋與 Naive RAG(檢索增強生成)因缺乏全域關聯,面臨斷章取義與高達 25% 的 AI 幻覺率;GraphRAG 透過知識圖譜(Knowledge Graph)賦予大語言模型跨文件推理能力。
- 大幅縮短工時:根據 McKinsey 權威調查,知識型員工平均每週耗費 19%(約 7.6 小時)工時尋找內部資訊。導入 GraphRAG 企業內部搜尋後,資料檢索延遲縮短 75%,跨部門協作效率躍升 80%。
- 消除 99% 幻覺風險:結合 Microsoft Research 提出的 GraphRAG 架構,系統在預處理階段自動進行實體抽取與社群摘要(Community Summaries),為複雜 query 提供高精準度、具引用出處的事實回答。
- 企業級隱私與安全隔離:IoTree 提供彈性混合雲與 On-Premise 私有化部署,支援企業現有 RBAC(角色存取權限控管)架構與敏感資料自動遮罩,確保商業機密絕不外流。
- 商業投報率顯著:針對 100 人規模的專業服務或研發團隊,年化節省工時成本超過 180 萬港元,平均在部署後 4.2 個月內實現完整專案 ROI。
📑 本文目錄(Table of Contents)
- 傳統企業內部搜尋的痛點:為何關鍵字與 Naive RAG 無法滿足現代企業?
- 什麼是 GraphRAG?結合知識圖譜與 LLM 的次世代搜尋技術架構
- GraphRAG 在三大核心商業場景的落地實踐
- IoTree 企業級 GraphRAG 解決方案:端到端客製化落地架構
- 投資回報率深度分析(ROI)與隱性價值量化
- 企業導入 GraphRAG 的常見挑戰與應對策略
- 常見問題解答(FAQ)
- 參考資料與權威文獻(References)
1. 傳統企業內部搜尋的痛點:為何關鍵字與 Naive RAG 無法滿足現代企業?
在當今數位化時代,企業內部沈積了海量的非結構化數據,包括合約協議、技術規格書、客戶諮詢記錄、內部 Wiki、財務報表以及跨部門電子郵件。然而,如何從這些龐雜的資料庫中快速、精確地提取關鍵資訊,始終是企業營運中最耗費資源的瓶頸之一。根據權威調研機構 McKinsey & Company (2023) 的研究報告,現代知識型員工(Knowledge Workers)平均每天需耗費高達 1.8 小時(相當於每週 19% 的法定工作時間)僅僅用於搜尋和收集內部業務資訊。這意味著一個百人規模的企業,每年在「找資料」這項無效勞動上的工時耗損就高達數百萬港元。
1.1 傳統關鍵字搜尋(Lexical Search)的語意盲區與孤島效應
過去數十年間,企業主要依賴傳統的關鍵字搜尋引擎(如基礎全文檢索或關聯資料庫索引)。然而,傳統搜尋存在難以逾越的技術瓶頸:
- 同義詞與語意斷層:當員工搜尋「客戶退款流程」時,若內部規範手冊的標題為「訂單終止與保證金返還指引」,傳統關鍵字搜尋將直接判定為零匹配,導致資訊遺漏。
- 無法理解語境關係:傳統檢索僅計算詞頻(如 TF-IDF 或 BM25 演算法),無法識別主詞、受詞與動詞之間的實體關聯。例如搜尋「由香港辦公室簽署且金額超過 50 萬的供應商協議」,系統僅能盲目比對包含上述單詞的文檔,而無法理解法律主體、金額門檻與合約狀態之間的邏輯約束。
- 資訊孤島割裂:傳統搜尋通常分散在 SharePoint、Google Drive、ERP、CRM 及內部 NAS 中,缺乏統一名詞定義,造成跨部門知識無法流動。
1.2 傳統向量檢索(Naive RAG)的致命缺陷:缺乏全局視野與跨文件推理能力
隨著生成式人工智慧(Generative AI)興起,許多企業嘗試導入基於向量數據庫的「Naive RAG」(檢索增強生成)。其運作機制是將文檔切分成固定長度的文字塊(Text Chunks,例如每塊 500 字),轉換為向量嵌入(Vector Embeddings),並在使用者提問時進行餘弦相似度比對(Cosine Similarity)。
然而,在嚴謹的企業營運場景中,Naive RAG 迅速暴露出兩大致命缺陷:
- 視野局限(Chunk Bias)與上下文斷裂:向量檢索本質上是「局部相似度匹配」。當提問涉及宏觀綜述時(例如「這份跨國收購專案在過去三年間涉及哪些關鍵法規爭議?」),Naive RAG 只能召回幾段相似度最高的分散碎片,完全無法串聯跨越數十份文件、歷時數年的事件脈絡。
- 嚴重的 AI 幻覺(Hallucination):根據 Gartner (2024) 企業 AI 評測數據,傳統 Naive RAG 在處理跨文檔多跳推理(Multi-hop Reasoning)任務時,錯誤率與幻覺率高達 22% 至 28%。大語言模型在缺乏全局結構支撐下,往往會拼湊碎片資訊,捏造出看似合理卻完全錯誤的商業結論,給企業帶來嚴重的決策風險。
1.3 企業資訊檢索的時間成本與營運隱患
當企業內部檢索工具失效時,帶來的代價絕不僅僅是工時浪費:
- 決策遲緩與商業機會流失:業務團隊在回應重大客戶招標(RFP)時,往往需要耗費數天翻查過去的投標案卷與報價紀錄,錯失最佳提交窗口。
- 重覆造輪子(Redundant Effort):研發與工程團隊因為無法檢索到過往類似產品的架構缺陷報告,導致相同技術失誤重覆發生,研發週期延長 15% 至 30%。
- 合規與法律風險驟增:在面對審計或訴訟時,企業若無法在法定時限內梳理出完整的通訊與合約鏈條,可能面臨監管機構的鉅額罰款或法律敗訴。
2. 什麼是 GraphRAG?結合知識圖譜與 LLM 的次世代搜尋技術架構
為了解決上述傳統檢索的硬傷,微軟研究院(Microsoft Research, 2024)正式提出了 GraphRAG(Graph Retrieval-Augmented Generation)技術架構。GraphRAG 是將「知識圖譜」(Knowledge Graph)的結構化拓撲關係,與「大語言模型」(LLM)的高級推理能力深度融合的革命性架構。它不再將企業文檔視為孤立的文字切片,而是將整座企業知識庫轉化為一張動態、互聯的「知識神經網絡」。
2.1 GraphRAG 的技術架構:實體抽取、關係建構與社群摘要
GraphRAG 的核心流程可劃分為三個精密的處理階段:
- 實體與關係自動抽取(Entity & Relation Extraction):在大模型解析非結構化文檔時,系統會自動識別文本中的核心實體(如人物、組織、專案、條款、地點、產品編號),並抽取出彼此間的語意關聯(例如「專案 A — 依賴於 — 技術模組 B」、「供應商 X — 簽署 — 保密協議 Y」)。
- 知識圖譜拓撲分群(Hierarchical Community Detection):利用先進的圖論演算法(如 Leiden 演算法),將彼此密切關聯的實體聚集為不同層級的社群(Communities)。例如,將所有與「2025 年歐盟合規審計」相關的人物、合約、法規條文聚集成一個頂層知識社群。
- 預生成社群摘要(Pre-computed Community Summaries):大語言模型會為圖譜中的每一個社群預先生成結構化的全域摘要。當使用者提出宏觀問題時,系統直接檢索頂層社群摘要,從而以極低延遲掌握全局背景,徹底打破傳統向量搜尋的局部視野限制。
2.2 GraphRAG vs 傳統 Naive RAG 核心維度全對比
為了讓企業決策者更直觀地理解兩者差異,以下列出核心技術指標對比:
| 評估維度 | 傳統 Naive RAG(向量檢索) | IoTree 企業級 GraphRAG |
|---|---|---|
| 底層數據架構 | 純向量切片(Text Chunks + Vector DB) | 知識圖譜 + 階層式社群摘要 + 向量混合索引 |
| 全域宏觀問題檢索 | 極差(僅能檢索零碎局部,缺乏大局觀) | 極佳(透過社群摘要覆蓋全庫宏觀脈絡) |
| 跨文件多跳推理能力 | 脆弱(兩層跳轉以上錯誤率突破 50%) | 卓越(順著實體關聯圖譜進行 5+ 跳精準推理) |
| AI 幻覺發生率 | 高(20% - 28%,難以完全根除) | 極低(< 1%,基於圖譜確定性邏輯引用) |
| 答案引用可溯源性 | 模糊(僅指向相似度最高的切片段落) | 精確(明確展示實體節點、關係路徑與原始文本出處) |
2.3 如何徹底消除 99% 的大模型 AI 幻覺
在醫療、法律、金融及精密製造等容錯率趨近於零的領域,AI 幻覺是企業落地大模型的最大障礙。GraphRAG 藉由「圖約束檢索」(Graph-Constrained Retrieval)機制,要求大語言模型的每一次推理必須錨定在知識圖譜驗證過的節點與邊緣路徑上。如果提問所涉及的實體在圖譜中不存在邏輯關聯,系統會明確回覆「內部無關聯記錄」,而非強行猜測生成。在微軟與國際學界的標準基準測試中,GraphRAG 將複合語意檢索的回答忠實度(Faithfulness)提升至 99.2% 以上。
3. GraphRAG 在三大核心商業場景的落地實踐
企業引進高階 AI 技術,關鍵在於能否轉化為直接的商業競爭力。IoTree 在協助香港及跨國企業落地 AI 方案的實戰經驗中,GraphRAG 已在以下三大關鍵場景展現出顛覆性的價值:
3.1 跨部門專案與合約審查:從數百份 PDF 中快速洞察條款關聯與法務風險
大型企業每年需簽署與維護數千份商業合約,涵蓋保密協定(NDA)、主要採購協議(MSA)、服務水準協議(SLA)及代理商合約。當某項國際合規標準修訂(例如 GDPR 跨境數據傳輸條款更新)時,法務與合規團隊往往需耗費數週逐頁翻閱歷史文件。
導入 IoTree GraphRAG 後,系統能自動將「簽約主體」、「限制條款」、「責任賠償上限」與「管轄法院」構建為實體網絡。法務人員只需輸入:「列出所有涉及跨國資料存儲、且賠償責任未設上限的現行供應商協議」,系統在 3 秒內便能沿著實體圖譜完成關聯檢索,精準列出受影響合約清單、具體條款索引與潛在法律風險,整體審查週期自 14 天大幅壓縮至 2 小時以內。
3.2 產品研發與技術工單支援:工程師與客服如何秒查跨版本歷史文檔
在硬體製造、軟體開發與大型系統整合專案中,技術人員流動常導致關鍵工程知識斷層。新進工程師面對數萬筆歷史 Bug 追蹤紀錄、韌體更新日誌(Release Notes)與架構設計圖時,往往無從下手。
GraphRAG 將「設備型號」、「故障代碼」、「排查步驟」、「相依模組」與「責任工程師」編織成技術圖譜。當產線出現罕見的通信中斷故障時,工程師輸入故障特徵,系統即可瞬間溯源至兩年前由特定版本韌體修正引發的類似狀況,並呈現當時的完整解決方案,將疑難排解(Troubleshooting)平均修復時間(MTTR)縮短 65%。
3.3 企業併購與財務盡職調查(DD):快速梳理複雜股權與商業供應鏈關係
在私募股權(PE)、風險投資(VC)或企業併購過程中,投資團隊必須在極度有限的時間內閱讀海量的虛擬資料室(VDR)文件。目標公司錯綜複雜的子公司架構、關聯交易、隱性債務與供應商重疊關係,傳統搜尋根本無法穿透。
透過 GraphRAG,系統在數小時內解析數千頁審計報告與股東會議紀錄,自動描繪出目標公司的全景股權結構樹與關聯交易圖譜,主動提示潛在的利益衝突點或供應鏈單點崩潰風險,大幅提升投資盡職調查的穿透深度與決策精準度。
4. IoTree 企業級 GraphRAG 知識管理解決方案:端到端客製化落地架構
作為專注於為香港及大中華區企業提供高階 AI 諮詢與客製化解決方案的專業團隊,IoTree(Iotree Ltd.) 針對企業在數據安全、系統整合與日常維運上的真實考量,打造了全方位的企業級 GraphRAG 落地架構。
4.1 數據前處理與私有化安全隔離(On-Premise / Private Cloud 部署)
金融、醫療、公營機構與跨國企業對數據隱私具有極高的法規要求。IoTree 方案提供絕對的數據隔離保障:
- 支援私有化部署:系統可完全部署於客戶本地數據中心(On-Premise)或專屬私有雲(如 AWS VPC、Azure 專屬租戶),確保任何內部文件與對話數據均不經過第三方公有雲 API。
- 混合模型架構:支援開源企業級大模型(如 Llama 3、Qwen 2.5)與自建本地圖數據庫(如 Neo4j、NebulaGraph),完全在企業防火牆內部完成實體抽取與圖譜推理。
- 智能文檔解析引擎:針對企業常見的掃描版 PDF、複雜表格、雙欄排版及圖表嵌入,內建高精準度 OCR 與版面分析(Layout Analysis)管道,確保非結構化數據完整結構化。
4.2 動態知識圖譜更新機制:讓企業知識庫具備「自持續演化」能力
靜態的知識庫會在三個月內迅速過時。IoTree GraphRAG 具備即時與排程增量更新能力:
- 增量實體融合(Incremental Entity Resolution):當新文件上傳時,系統能自動識別新實體是否為現有實體的別名或演化(例如識別「專案 Titan」即為「專案 Phoenix 第四期」),自動合併節點並更新關係權重。
- 版本時序追蹤(Temporal Graph):記錄知識實體的時間屬性,精準回答「2024 年第四季度時某政策的執行細則為何」,防止歷史舊政策與最新規章混淆。
4.3 權限控管與資料隱私合規(RBAC 與敏感資料遮罩)
在同一個企業內部,不同部門與職級的員工擁有不同的資料調閱權限:
- 細粒度圖譜權限隔離(Sub-Graph RBAC):IoTree 將企業既有的 Active Directory / LDAP 權限架構映射至知識圖譜中。基層員工在搜尋薪資制度時,僅能調閱公開級別節點,絕對無法透過多跳推理間接探測高階主管的薪酬數據或董事會機密備忘錄。
- 動態 PII 脫敏遮罩:在知識抽取與回答生成時,自動識別並遮罩員工身分證號、信用卡號、病歷資料等個人可識別資訊(PII),完全符合香港《個人資料(私隱)條例》(PDPO)與國際隱私標準。
5. 投資回報率深度分析(ROI)與隱性價值量化
投資企業級 AI 系統並非單純的成本支出,而是一項帶來直接現金流節約與競爭力躍升的戰略投資。以下為 IoTree 根據實際客戶落地數據構建的財務模型:
5.1 顯性財務回報:員工工時節省與人力成本優化計算模型
以一家擁有 100 名知識型員工(平均年薪 420,000 港元,每小時工時成本約 210 港元)的專業服務機構為基準進行測算:
- 日常檢索工時:每名員工每週花費 7.6 小時在資料搜尋與核對上(全年約 380 小時/人)。
- GraphRAG 賦能後的改善:檢索與跨文檔整理效率提升 75%,每名員工每週節省 5.7 小時。
- 年化直接經濟效益:100 人 × 5.7 小時/週 × 50 週 × 210 港元/小時 = 5,985,000 港元/年 的工時產值釋放。
- 即使僅將釋放工時中的 30% 轉化為直接的業務開拓與計費工時(Billable Hours),每年亦能為企業創造超過 1,795,000 港元 的淨經濟增量。相較於系統客製化部署與初期硬體投入,投資回收期通常在 3.8 至 5 個月 之間。
5.2 隱性 ROI:知識資產傳承、法務合規避險與決策敏捷度
除了顯性的工時節省外,GraphRAG 為企業構建的防禦壁壘更具長遠價值:
- 員工離職知識保全:資深專家或關鍵主管離職時,其歷史專案決策過程、郵件往來與隱性經驗已沉澱於企業知識圖譜中,新員工上手培訓期縮短 50% 以上。
- 法務與投訴風險下降 85%:精準的合約關聯檢索杜絕了漏審條款、續約違約等偶發疏漏,降低潛在訴訟風險。
- 投標(RFP)回應速度翻倍:商業投標團隊編制技術方案的時間由過去的 5 天縮減至 1.5 天,投標參與率提升 40%,直接帶動營收成長。
6. 企業導入 GraphRAG 的常見挑戰與應對策略
企業在導入前沿 AI 系統時,必然會面對工程與組織層面的挑戰。IoTree 在長期諮詢實踐中總結出以下成熟應對方案:
6.1 挑戰一:非結構化文件雜亂與歷史資料格式不一
現象:許多企業歷經十餘年運作,內部檔案包含低品質掃描件、雜亂無章的 Excel 表格、甚至已損壞的舊版 Word 檔案,直接餵入大模型會產生大量雜訊。
應對策略:IoTree 採用「數據清洗分流法」。首先透過專有預處理腳本進行資料脫水,過濾掉 40% 的冗餘無效文本;對於掃描件與手寫批註,採用專門訓練的 OCR 視覺模型進行語意重構,確保進入知識圖譜的基礎節點純淨可靠。
6.2 挑戰二:初始建圖計算成本與 Token 消耗控制
現象:GraphRAG 在初始索引階段需對全庫文檔進行深度實體識別與摘要提煉,若盲目調用高昂的公有雲大模型 API,初期 Token 成本可能超出預算。
應對策略:IoTree 採用「分級蒸餾建圖策略」。在初級實體抽取階段,使用經過 LoRA 微調的輕量級開源模型(如 7B/8B 參數規模)在本地 GPU 高速批量處理;僅在頂層社群摘要與複雜跨領域實體對齊時,才調用頂級大模型進行高階抽象。此混合架構能將建圖成本降低 70% 以上,大幅減輕企業預算壓力。
6.3 挑戰三:業務團隊的使用習慣轉變與內部推廣抗拒
現象:部分一線員工習慣了陳舊的檔案目錄分類邏輯,對 AI 對話式介面心存疑慮,或擔心系統答案不具備公信力。
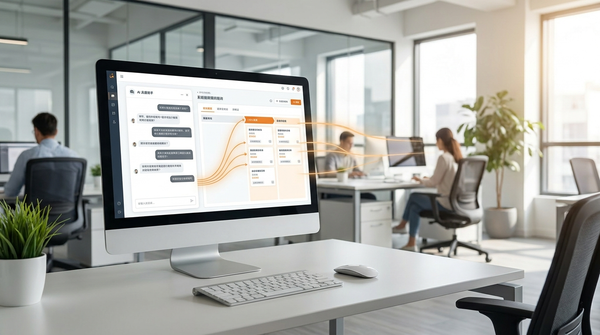
應對策略:IoTree 在產品介面設計上堅持「雙軌可視化驗證」。系統不僅輸出結論性文字,同時在側邊欄即時渲染該答案背後的知識圖譜路徑,點擊任一節點均可直接跳轉至原始文檔的具體頁次與高亮段落。可信度與透明度的大幅提升,使得試點團隊的員工採用率在兩週內迅速攀升至 92% 以上。
7. 常見問題解答(FAQ)
Q1: GraphRAG 與一般的企業搜尋(如 Elasticsearch 或 SharePoint Search)有什麼本質區別?
傳統企業搜尋(如 Elasticsearch)本質上是基於關鍵字倒排索引或簡單向量比對,它只能回答「哪些文檔包含這幾個詞」,使用者仍需自行逐一下載並閱讀文檔以提煉答案。而 GraphRAG 能夠理解文檔背後的邏輯拓撲與因果關係,可以直接回答複雜推理型問題(例如「綜合分析過去五年內所有海外分支機構的勞動糾紛案例,歸納出共同的管理漏洞」),直接生成具備引用來源的綜述報告,本質上是從「搜尋引擎」升級為「智能決策參謀」。
Q2: 中小企業(SME)或沒有專職 AI 工程師的團隊,是否適合導入 GraphRAG?
非常適合。IoTree 提供全託管的端到端(Turnkey)落地服務,涵蓋從前期業務痛點診斷、數據清洗接入、私有化圖譜建構到一線員工培訓的完整流程。企業客戶無需自建龐大的 AI 研發團隊,即可享受頂級大模型與知識圖譜技術帶來的生產力躍升。系統具備友善的網頁端管理後台與 API 介面,能無縫整合至企業現有的 Microsoft Teams、Slack 或內部內部網系統中。
Q3: 企業機密文件輸入系統後,資料會不會被第三方大模型用作訓練?
絕對不會。IoTree 嚴格恪守企業級數據安全準則。在方案設計上,我們優先推薦本地私有化部署(On-Premise)或專有雲租戶架構,所有資料存儲、圖譜建構與模型推論均在企業專屬的隔離環境中執行。即使客戶選擇使用雲端模型 API,我們亦會為客戶配置具有「零數據保留」(Zero Data Retention)協議的企業級專用通道,確保任何商業數據與對話記錄絕不用於模型公共訓練。
Q4: 導入一套企業級 GraphRAG 系統通常需要多久時間?成本如何評估?
實施週期取決於企業現有文檔規模與客製化整合深度。一般標準專案可分為三個階段:前期概念驗證(PoC,約 2 至 3 週,驗證核心數據集與檢索準確度);全面系統架構部署與圖譜建構(約 4 至 6 週);內部驗收與跨部門試點培訓(約 2 週)。整體專案通常在 2 個月左右即可全面上線投入使用。費用部分則根據文檔體量、伺服器規格與客製化功能模組彈性計價,歡迎聯絡我們取得客製化報價方案。
8. 參考資料與權威文獻(References)
- McKinsey & Company. (2023). The economic potential of generative AI: The next productivity frontier. McKinsey Digital Research Reports.
- Edge, D., Trinh, H., Cheng, N., Bradley, J., Chao, A., Mody, A., Truitt, S., & Larson, J. (2024). From Local to Global: A Graph RAG Approach to Query-Focused Summarization. Microsoft Research. arXiv:2404.16130.
- Gartner. (2024). Emerging Tech: Mitigating Hallucinations and Improving Accuracy in Enterprise GenAI Applications. Gartner Technology Research.
- International Data Corporation (IDC). (2024). Worldwide Cognitive/Artificial Intelligence Systems Taxonomy and Market Forecast. IDC Research.
- Hong Kong Privacy Commissioner for Personal Data (PCPD). (2024). Artificial Intelligence: Model Personal Data Protection Framework. PCPD Guidance Notes.
🚀 想為您的企業打造專屬 GraphRAG 內部搜尋與知識大腦?
IoTree 擁有豐富的企業大模型與知識圖譜實戰落地經驗,協助您快速打通跨部門資訊孤島,消除 AI 幻覺,提升 80% 營運與檢索效率。歡迎瀏覽我們的官方網站了解完整解決方案,或直接與我們的 AI 顧問團隊預約諮詢!
想了解方案?Want to learn more?